Spring 서비스 간 의존, 어디까지 허용될까? Service vs Repository vs Facade
스프링으로 개발을 하다보면 아래와 같은 상황이 자주 생길 것이다.
Post라는 글을 처리하는 비즈니스 로직에서 User를 처리해야할 경우와 같이
서로 다른 도메인을 건드려야하는 경우이다.
이때 우리는 크게 3가지 방법을 사용할 수 있다.
3가지 방법
1. 서비스에서 서비스 의존
@Service
@RequiredArgsConstructor
public class PostService {
    private final UserService userService;

    public boolean check(Post post, Long userId) {
        User user = userService.find(userId);

        return post.getUser().equals(user);
    }
}
예를 들어 위와 같은 글의 작성자와 사용자가 일치하는지 확인하는 코드가 있다고 하자.
그럴 때, 이와 같이 PostService에서 UserService를 직접 호출하는 경우이다.
2. 서비스에서 리포지토리 의존
@Service
@RequiredArgsConstructor
public class PostService {
    private final UserRepository userRepository;

    public boolean check(Post post, Long userId) {
        User user = userRepository.findById(userId);

        return post.getUser().equals(user);
    }
}
1번에서의 코드와 같은 동작을 하지만 해당 코드에서는 UserService를 호출하는 것이 아니라
UserRepository를 호출하여 동작한다.
3. 상위 서비스에서 다른 서비스 호출
@Service
@RequiredArgsConstructor
public class PostServiceFacade {
    private final UserService userService;
    private final PostService postService;

    public boolean check(Post post, Long userId) {
        User user = userService.find(userId);

        return postService.check(post, user);
    }
}
이번에는 Facade 패턴을 사용하여 두 서비스의 상위 서비스에서 나머지 서비스를 호출해서 사용하는 경우이다.
위와 같이, 3가지 방법 중에 우리는 어떤 방법을 쓰는 것이 좋을까?
결론을 미리 말하자면, 정답은 없다!
지금부터 이유를 설명해보겠다.
3가지 방법의 장단점
1. 서비스에서 서비스 의존
- 장점
- 단점
여기서 순환 참조가 일어날 수 있다. 라는 내용은 대부분의 사람들의 의견으로는 단점이라기보단 해당 내용은 개발자의 설계 오류라고 생각하는 사람들이 많은 것 같다.
2. 서비스에서 리포지토리 의존
- 장점
- 단점
3. 상위 서비스에서 다른 서비스 호출
- 장점
- 단점
위와 같이 각 방법이 모두 장단점이 존재한다.
여기서 우리는 다른 전문가분들의 의견을 볼 필요가 있을 것이다.
전문가 의견
스택오버플로우 의견
해석
요약하자면 비즈니스 로직이 필요하지 않다면 Repository를, 비즈니스 로직이 필요한 경우라면 코드 중복 제거를 위해 Service를 의존해서 사용해도 괜찮다는 의견이다.
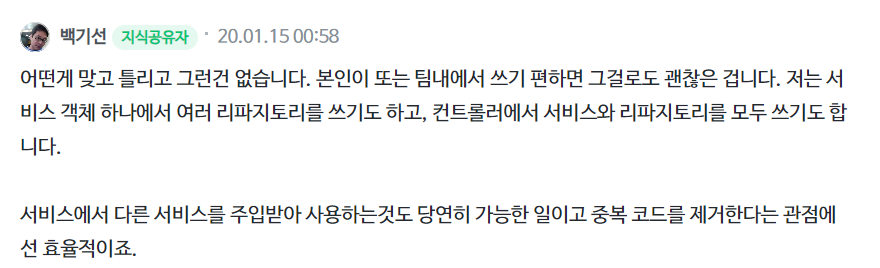
다음은 (전)네이버, 아마존 개발자이자 (현) 마이크로소프트의 시니어 개발자인 백기선님의 의견이다.
이분은 특이하게 컨트롤러에서도 Repository를 직접 사용하기도 한다는 것이다.
마지막으로 현재 카카오에서 백엔드 개발자로 근무 중이신 김우근 님의 의견이다.
김우근님은 Facade 패턴을 학습한 개발자가 주로 생각하는 것이
Facade 패턴을 사용한다 = 서비스가 다른 서비스를 참조해서는 절대 안된다!
라고 생각하는 경우가 많은데 그것이 아니라는 것이다.
의존관계를 지나치게 망치지 않는다면 다른 서비스를 참조해도 괜찮다! 라는 의견이다.
우리가 흔히 Facade 패턴을 쓴다고 하면 그저 복잡하고 지저분한 것들을 가려주는 가림막을 만드는 것과 같다는 것이다.
즉, Facade 패턴을 적용시키면서 새로운 유형의 서비스를 만드는 것에 불과하다는 것이다.
예를 들어, 김우근씨가 언급한 코드를 보자.
public class UserServiceFacade {

    // ...

    @Transactional
    public void update(UserUpdate userUpdate) {
        this.userService.update(userUpdate);
        this.fileService.saveAndUpload(userUpdate.getProfileImage());
    }
}
위의 코드가 아래와 다를게 뭐냐는 것이다
public class UserServiceImpl implements UserService {

    // ...

    @Transactional
    public void update(UserUpdate userUpdate) {
        this.update(userUpdate);
        this.fileService.saveAndUpload(userUpdate.getProfileImage());
    }

    private void update(UserUpdate userUpdate) {
        // ...
    }
}
또, 아래랑 다를 것은 무엇인가?
public class UserUpdateService {

    // ...

    @Transactional
    public void update(UserUpdate userUpdate) {
        this.userService.update(userUpdate);
        this.fileService.saveAndUpload(userUpdate.getProfileImage());
    }
}
이러한 이유로 김우근씨는 Facade 패턴의 필요성을 잘 모르겠다고 한다.
이 부분은 나도 동의하는 부분이다.
결론은 서비스가 다른 서비스를 호출하는 것은 주의해야 하는 부분이 맞긴 하지만, 너무 경계하고 쓰지말자! 라고 할 필요까지는 없다는 것이다. 순환 참조가 일어나지 않고, 책임이 과하게 할당되는 것만 방지하면서 사용하면 괜찮다라는 의견이다.
함께 읽으면 좋은 글
대규모 트래픽 경험기 - 대기열
이전 글에서 Pessimistic Lock으로 동시성 문제를 해결했다. 이번에는 한 단계 앞으로 가서, "애초에 서버에 동시에 들어오는 요청 수를 제어하면 어떨까?" 라는 질문에서 출발한다. 콘서트 티켓 오픈 시간에 2000명이 동시에 좌석 조회를 요청한다고 가정하자.
대규모 트래픽 경험기 - 동시성 제어
현재 코드는 성능적인 문제를 어느정도 해결했지만 동시성 문제를 해결하지 못한다. 예를들어, 10명의 사람이 한 좌석에 대해 동시에 예약을 한다면 아래와 같이 10명 모두 같은 좌석을 예매할 수 있게 된다.
대규모 트래픽 경험기 - SSE
3편에서 API를 seat-map(정적 메타)과 seat-status(동적 상태)로 분리하고, DTO 프로젝션으로 조회 비용을 줄였다. 2000명 동시 접속 기준 TPS 51 → 136, p95 36초 → 13초. 처리량 2.7배, Tail Latency 2.6배 개선이었다.
대규모 트래픽 경험기 - api 분리
Redis 캐시를 적용했지만 결과는 기대 이하였다. TPS 48 → 57, 평균 응답 19.2초 → 18.2초. DB 접근은 2초에 1회까지 줄였는데도 체감 성능은 거의 그대로였다. 분석 결과 병목은 이미 DB가 아니었다.